香港服务器怎么托管常见故障排查与快速恢复流程一览
香港服务器发生无法访问或网络不稳定时,首要确认是链路问题还是配置问题。可先从本地到目标机做ping与traceroute定位跳点。
步骤一(H3):使用ping与traceroute诊断,判断丢包或跃点异常。
步骤二(H4):检查服务器网卡配置、默认路由与防火墙(iptables、ufw、Windows防火墙)规则。
步骤三(H5):登录机房控制台或通过远程管理(IPMI/ILO/DRAC)查看物理端口与交换机状态;必要时联系机房提供商确认上游链路。
恢复提示:若为路由或链路问题,临时可切换出口、调整BGP或请求机房修复;配置错误则回滚网络设置或重启网卡后验证。
硬件故障往往表现为磁盘I/O错误、内核panic或频繁重启。先查看系统日志(/var/log/messages、dmesg)定位设备错误码。
步骤一(H3):通过smartctl检查磁盘SMART状态,确认是否有预警。
步骤二(H4):运行内存检测工具(memtest86)或查看kernel OOPS记录以识别内存ECC错误。
步骤三(H5):如果确定硬件故障,立即触发机房售后流程,申请更换硬盘、内存或主板,并在更换前尽快做数据快照或快备份。
系统无法启动时,优先判断是内核、文件系统损坏还是启动项被误改。使用机房远程控制台进入单用户模式或救援系统。
步骤一(H3):通过救援盘挂载原分区,检查/boot、fstab、grub配置与分区UUID是否变更。
步骤二(H4):使用fsck修复文件系统,或从备份恢复关键配置文件与数据。
步骤三(H5):若内核损坏,可使用救援系统chroot并重装内核包,确认initramfs与grub正确后重启。
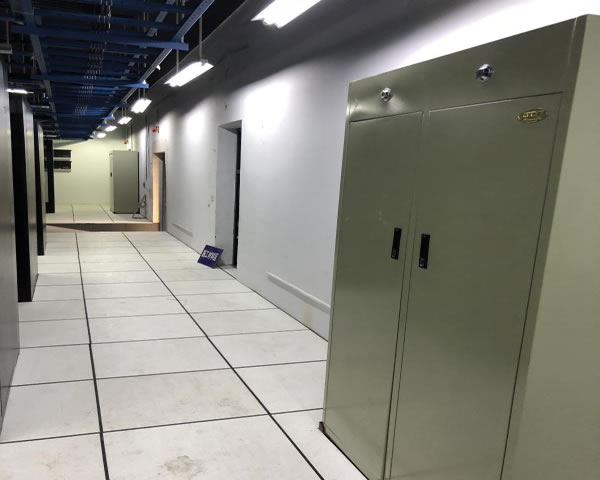
磁盘满或I/O瓶颈会导致服务不可用。先用df、du找出大文件,用iostat、iotop确认磁盘使用与等待时间。
步骤一(H3):清理临时文件、日志归档并压缩旧数据;对于日志频繁增长,设置logrotate并限制大小。
步骤二(H4):对数据库进行慢查询分析,添加必要索引或优化SQL,必要时开启只读模式并扩容磁盘或迁移到更大盘。
步骤三(H5):若为短期突发,临时扩展云/机房提供的磁盘或挂载额外数据盘,随后做长期容量规划与监控告警。
面对DDoS或入侵,第一时间启动应急响应:隔离受影响实例、保存日志并通知机房安全团队。
步骤一(H3):启用机房或防火墙提供的流量清洗服务、黑洞路由或速率限制,以减轻流量峰值。
步骤二(H4):分析入侵痕迹(登录记录、异常进程、Cron任务、可疑网络连接),立即更换受影响的密钥与密码。
步骤三(H5):恢复服务时优先使用干净镜像或备份,逐步放流并持续监控;事后做安全加固(最小权限、WAF、入侵检测、定期审计)。
-
跨境业务加速实战香港服务器托管深圳节点优化全流程
本文为从选型到部署再到运维的可落地实战指导,围绕如何用香港出口资源结合深圳节点实现跨境访问稳定与低延迟,包含选购要点、链路优化、带宽与安全配置以及持续监测与成本控制建议,便于工程与运维团队快速执行。 如何选择合适的香港服务器型号与带宽方案? 选择香港服务器时,应优先评估业务类型(静态内容、动态请求、API或流媒体)、并发量与峰值带宽2026年5月17日 -
香港学校计算机机房节能与散热方案的最佳实践分享
香港学校计算机机房节能与散热:实战指南(作者:机房节能工程师,10年实操经验) 1. 精华:通过热通道/冷通道与密闭隔离,能使机房空调效率提升20%-40%。 2. 精华:采用变频风机、智能温控与分区制冷,通常可把学校机房的年电费降低25%以上,回收周期短。 3. 精华:小型学校机房优先考虑被动与混合冷却策略(加强通风、机柜封2026年6月25日 -
香港的机房都在哪个区域 金融与云服务接入优势对比研究
本文概述了香港机房的主要分布与不同用途下的接入优势:在地段、网络互联、延迟与合规性方面,面向金融接入的部署与面向云服务接入的部署存在显著差异。文章逐项比较了区域特点、技术能力与选址建议,便于企业根据业务侧重点做出更符合需求的机房选择。 香港的机房主要集中在多少个区域? 总体来看,香港机房呈现为若干带状或点状集群,常见可划分为大约四到六个主要区2026年8月24日 -
香港交易所平台机房图片中能学到的运维与故障应对策略
要点概览 从香港交易所平台的机房图片中可以提炼出核心的运维与故障应对策略精华:一是物理与电力冗余要到位,二是网络与路由多线接入并辅以CDN与DDoS防御,三是监控、告警与演练要常态化以保证故障时快速恢复。图片里的线缆规范、机柜布局、冷通道/热通道分离和标签管理都在提醒我们在做服务器、VPS或主机部署时应把物理可靠性与网络弹性并重。实际运营中,推2026年5月17日 -
如何在香港服务器专业托管商城快速找到合适的机房和配置
在香港市场寻找合适的机房和服务器配置,需要兼顾网络质量、地理位置、硬件规格与售后保障。本文按步骤说明在专业的托管商城上快速筛选与比较机房、判断链路和延迟、确定合适的配置与带宽策略,并提醒合规与预算要点,便于您在短时间内锁定最优方案。 哪个机房更适合我的业务场景? 选择机房首先看目标用户分布与业务类型。若用户主要在中国大陆,优先考虑与2026年8月4日 -
部署指南香港原生ip怎么样配置防火墙与安全策略
部署指南:香港原生IP防火墙与安全策略(实战速成) 1. 精华:先把香港原生IP的边界当成第一道战线,默认拒绝,逐条放行。 2. 精华:结合WAF与IDS/IPS做纵深防御,别只靠单一设备。 3. 精华:日志与告警才是王道,SIEM+自动化响应切断攻击链。 作为具有多年企业级部署经验的网络安全工程师,我把这份指南做成了可复制、可验证的路线图2026年8月3日 -
运营观察 香港原生ip机场在哪 与国际骨干网的连接关系
随着跨境业务和内容分发需求增长,“香港原生IP机场”成为很多企业与个人用户关注的对象。所谓原生IP机场,通常指提供香港公网地址段的代理或节点服务,真正落地在香港数据中心并拥有本地路由表与ASN的服务商。 在地理位置上,这类原生IP节点多部署在靠近海底光缆落地点和骨干网络交换中心的数据中心内。香港的主要数据中心集群分布在新界和九龙一带,以及靠近机2026年4月14日 -
阿里云香港机房详细地址常见问题解答与快速上手部署指南
阿里云香港机房通常指阿里云在香港地区的云资源可用区(Region:香港),用于部署面向香港及亚太用户的云服务器、VPS、存储与网络服务。关于“详细地址”的查询,阿里云出于安全与合规考虑不会公开精确机房位置,通常通过区域或可用区标识来区分机房资源。 常见问题一:如何查询阿里云香港机房的可用区与网络延迟?可以在阿里云控制台选择Region为香港后,通过2026年5月5日 -
香港vps云服务器 美国vps在全球访问与性能优化上的全面对照
问题一:从全球访问角度看,香港vps云服务器和美国vps的主要差异是什么? 答:总体上,香港vps云服务器在亚太地区尤其是中国大陆、台湾、香港、东南亚的延迟和路由表现通常更优,适合面向中文用户或亚洲流量的业务;而美国vps对美洲、部分欧洲用户以及跨大西洋业务更有优势。香港节点受益于近海光缆与亚洲互联互通,但可能在国际出口带宽与部分目的地产生少量2026年9月11日